Overvågning skal ikke kun fortælle dig, når noget er nede. Den skal også fortælle dig, når noget ikke er normalt.
Sagen om de 8,8 millioner CPR-numre, der blev tilgået gennem en legitim integration, er en påmindelse om en udfordring, som let bliver overset i arbejdet med overvågning og sikkerhed. Noget kan godt fungere teknisk og samtidig være ude af kurs.
Nogle gange er systemet oppe. Integrationerne virker. API’erne svarer. Trafikken bliver behandlet. Det er først, når man ser på adfærden, at noget begynder at se forkert ud. Det er netop den type problemstilling, Splunk IT Service Intelligence kan være med til at adressere.
Når alt ser rigtigt ud
Forestil dig en API, der normalt håndterer omkring 1.000 forespørgsler i timen.
Det er det normale niveau, men en dag kommer der 10.000 forespørgsler. Derefter 100.000 og måske endda 1 million.
API’en svarer stadig. Der er ikke nødvendigvis en fejl. Ingen server er gået ned, og ingen alarm fortæller, at servicen er utilgængelig. Men noget er tydeligvis anderledes.
Spørgsmålet er derfor ikke kun: Er servicen oppe?
Det er også: Opfører servicen sig, som den plejer?
Fra oppetid til adfærd
Traditionel overvågning er ofte bygget op omkring konkrete grænser:
- CPU-udnyttelsen må ikke overstige et bestemt niveau.
- Svartiden må ikke komme over en bestemt værdi.
- Fejlprocenten må ikke overstige en bestemt tærskel.
Alle er vigtige parametre, men de fortæller ikke nødvendigvis hele historien. For hvad hvis det interessante ikke er, at en værdi er for høj, men at den er markant anderledes end normalt?
En service, der altid har håndteret 1.000 forespørgsler i timen, kan måske godt håndtere 10.000 og teknisk set stadig fungere. Men samlet set kan ændringen være vigtig. Det samme gælder svartider, fejl, brugsmønstre, klienter og andre KPI’er.
Hvad kan Splunk IT Service Intelligence bidrage med?
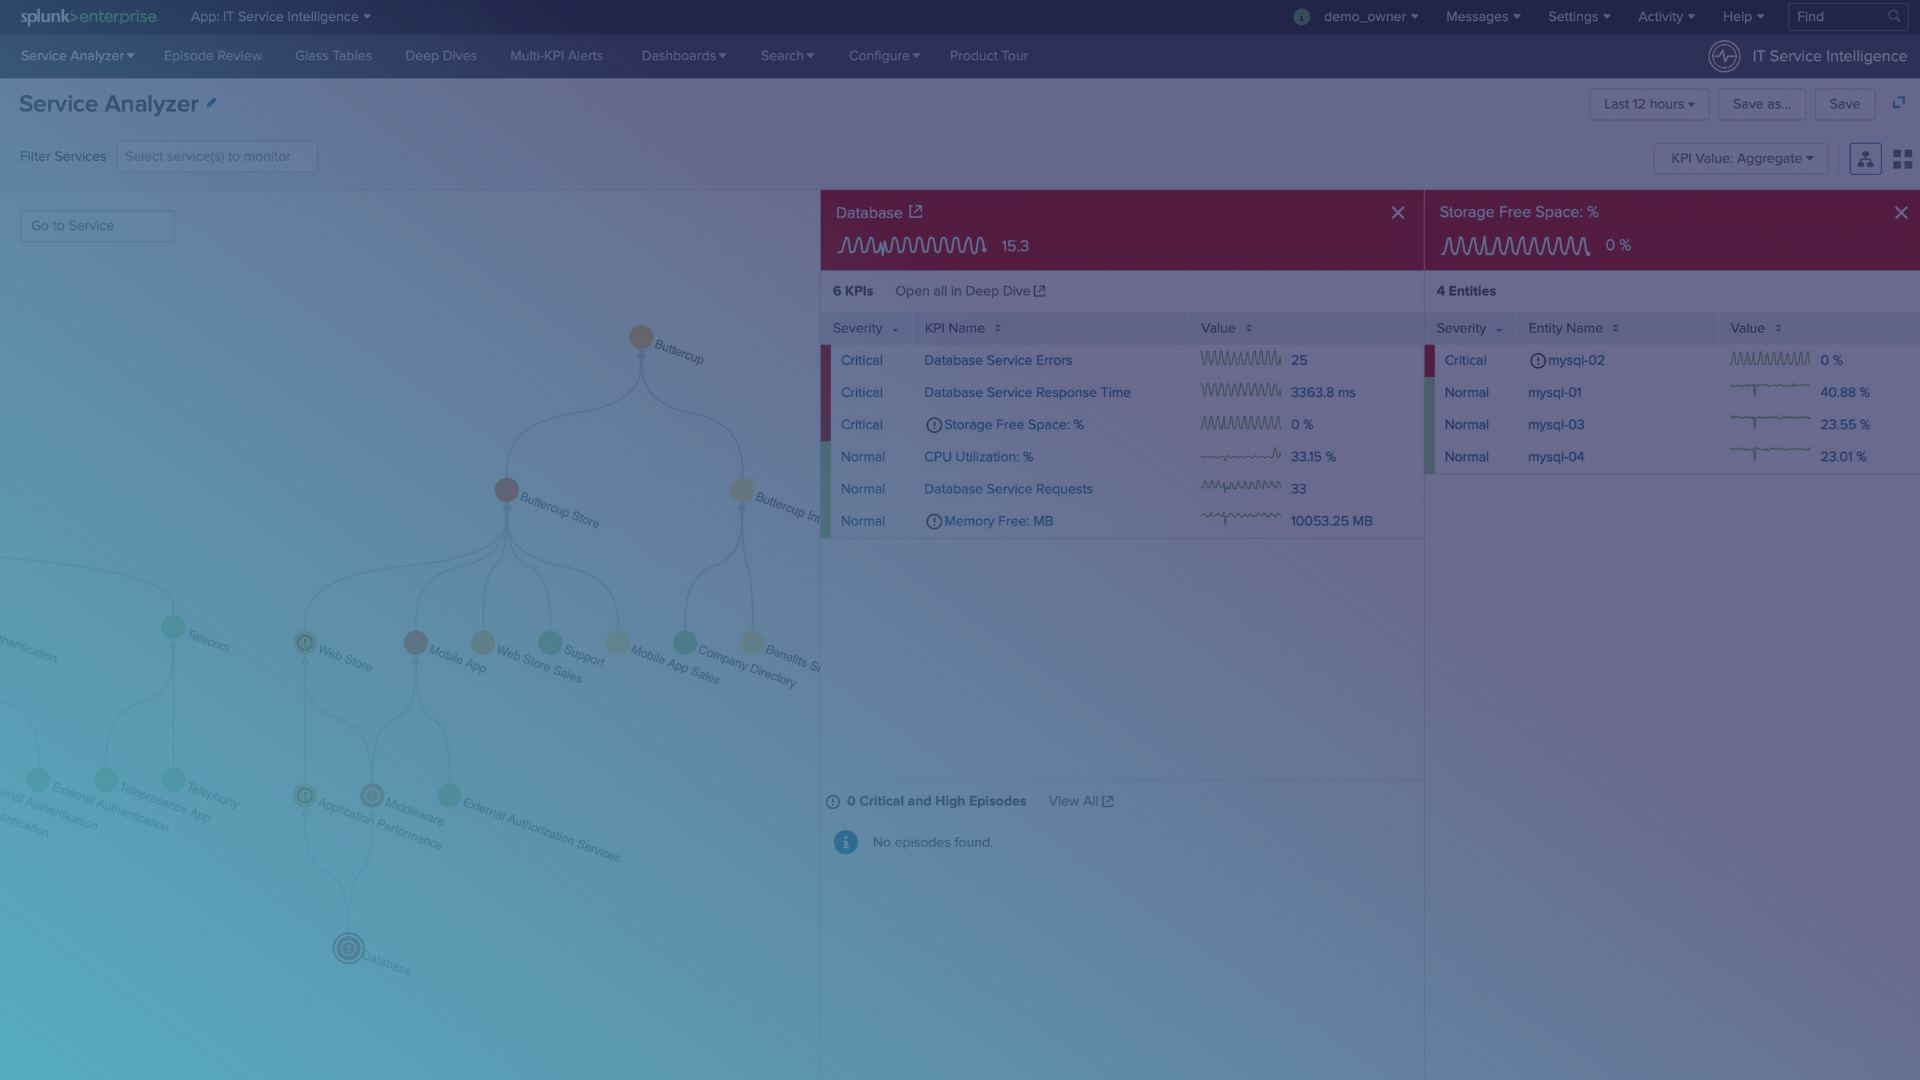
Splunk IT Service Intelligence – eller ITSI i daglig tale – er bygget til at give et samlet billede af, hvordan kritiske services har det.
ITSI samler relevante KPI’er og data omkring services, så man kan følge udviklingen og identificere, når noget afviger fra det forventede.
Det kan eksempelvis være:
- Et pludseligt hop i antallet af API-kald
- En ændring i svartider
- En stigende fejlprocent
- En klient, der pludselig opfører sig anderledes end tidligere
- Et ændret mønster i brugen af en service
Med historiske data kan ITSI etablere et billede af normal adfærd og bruge adaptive tærskler og anomalidetektion til at identificere væsentlige afvigelser. En afvigelse er ikke nødvendigvis et sikkerhedsproblem, men den kan være et godt sted at begynde at stille spørgsmålet: Hvorfor er det her anderledes end normalt?
Det interessante er ofte ændringen
I sikkerhedsarbejde leder vi ofte efter det, der er forkert, men nogle gange er det mere relevant at lede efter det, der er anderledes.
Det kan være en lille ændring i starten.
- En bestemt klient sender lidt flere forespørgsler end normalt.
- En service bliver brugt på et andet tidspunkt.
- Et bestemt mønster gentager sig.
- En KPI bevæger sig langsomt væk fra det normale.
Hver enkelt observation behøver ikke være alarmerende. Men samlet kan de fortælle en anden historie.
Overvågning er ikke det samme som sikkerhed
Det er vigtigt at skelne mellem overvågning og sikkerhed. Splunk ITSI er ikke en magisk detektor, der fortæller, at der foregår et datamisbrug. Og anomalidetektion kan ikke i sig selv afgøre, om en ændring er legitim eller ondsindet.
Det, den kan, er at gøre det lettere at opdage, at noget er ændret. Hvad det betyder, kræver kontekst, relevante data og de rigtige mennesker.
God overvågning handler derfor ikke om at producere flere alarmer, men om at give de relevante teams et klart billede af, hvad der er ændret, hvor det er ændret, og hvad der fortjener deres opmærksomhed.
Når systemet stadig fungerer
En service behøver ikke være nede, for at noget er galt. Den kan fungere præcis som forventet teknisk set – og alligevel blive brugt på en måde, der ikke er normal.
Derfor bør overvågning af kritiske services ikke kun besvare spørgsmålet: virker det? Den bør også hjælpe med at besvare: er det normalt?
Og når det handler om kritiske services og følsomme data, kan den forskel være afgørende.
Er du nysgerrig på, om jeres overvågning fortæller jer nok?
Vi hjælper med at få mere ud af de data, I allerede har – og med at gøre det lettere at opdage, når noget ændrer sig.
Tag fat i Martin Terp, Manager – Observability, på mail terp@wingmen.security.